DDPM: Diffusion Model Background
DDPM: Denoising Diffusion Probabilistic Model의 Introduction과 background 부분에 서술된 Diffusion 모델 기초에 설명이 부족해 여러 블로그를 참고해 따로 서술해본다.
0. Abstract1. Introduction2. Background(1) Forward Diffusion Process (q)(2) Reverse Diffusion Process (p)(3) Objective Function (Loss)References
0. Abstract
이 논문에서는 nonequilibrium thermodynamics로부터 고안된 잠재 변수 모델 중 하나인 diffusion probabilistic models를 제안한다. 이 diffusion probabilistic model은 high quality image synthesis를 수행 할 수 있다. 이 논문에서는 diffusion probabilistic model과 Langevin dynamics의 denoising score에 적절한 connection을 사용한다.
1. Introduction
- 본 논문은 diffusion probabilistic models의 progress를 소개한다.
- Diffusion model은 data에 noise를 조금씩 더해가거나 noise로부터 조금씩 복원해가는 과정을 통해 data를 generate하는 모델이다.
- 이를 한 눈에 표현하면 아래 그림과 같다. 아래 그림에서
는 실제 데이터, 는 최종 noise, 그리고 그 사이의 는 데이터에 noise가 더해진 상태의 latent variable을 의미한다.
- 즉, Diffusion model의 goal은 를 찾는 것이다. (는 reverse process에 해당하며, 는 와 같은 차원의 latents)
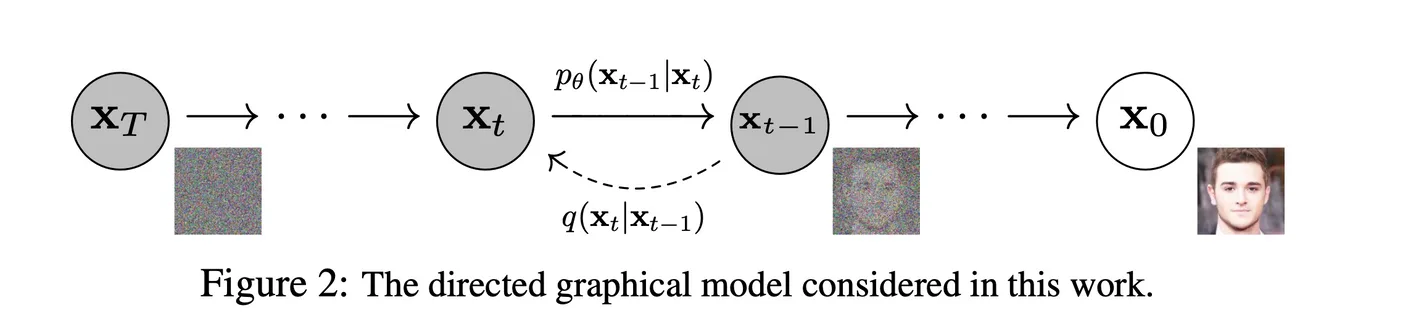
- 우선, 위 그림의 오른쪽에서 왼쪽 방향으로 noise를 점점 더해가는 forward process 를 진행한다. 그리고 이 forward process를 반대로 추정하는 reverse process 를 학습함으로써 로부터 를 복원하는 과정을 학습한다.
- 이 reverse process를 활용해서 random noise로부터 우리가 원하는 image, text, graph등을 generate할 수 있는 모델을 만들어내는 것이다.
2. Background
(1) Forward Diffusion Process (q)
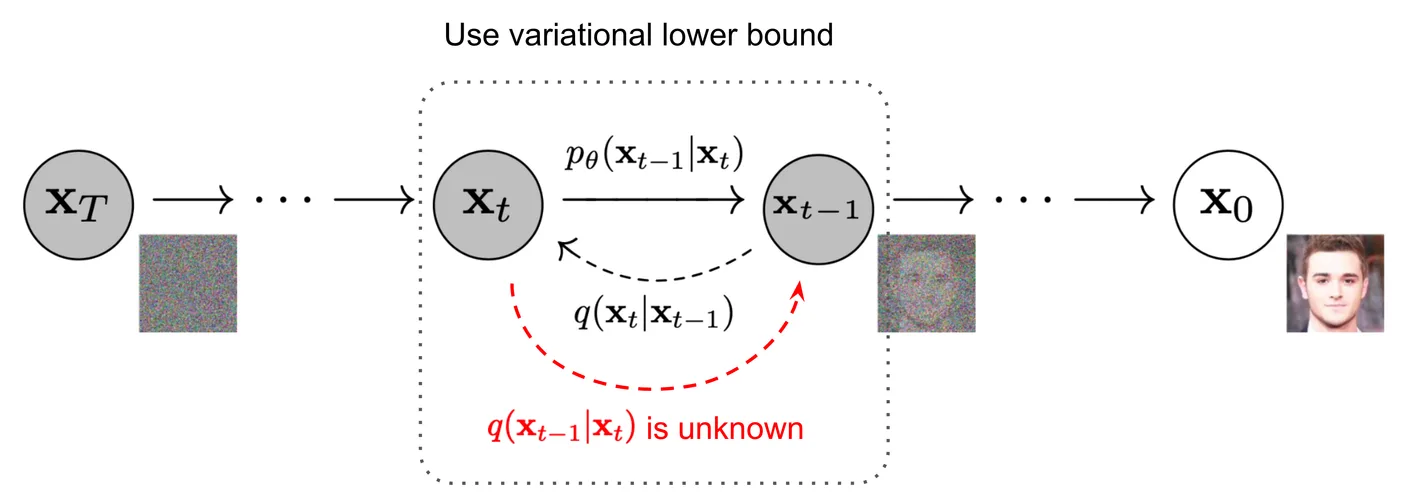
- Forward Diffusion Process, q는 markov chain으로 부터 noise를 더해가면서 최종 형태로 가는 과정이다. (sampling의 반대방향) 우리가 이 과정의 분포를 알아내야 하는 이유는, reverse process의 학습을 forward process의 정보를 활용해서 하기 때문이다.
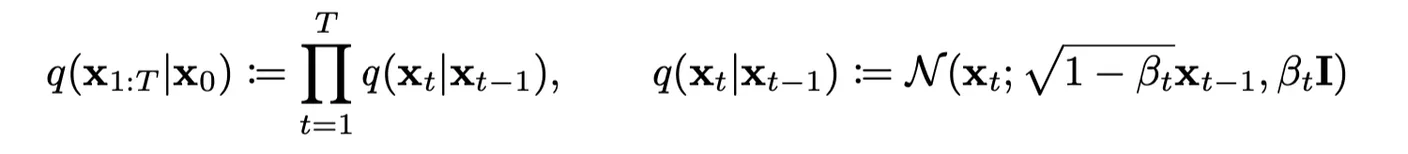
- data에 noise를 추가할 때, variance schedule 를 이용하여 scaling을 한 후 더해준다.
- 매 step마다 gaussian distribution에서 reparameterize를 통해 sample하게 되는 형태로 noise는 추가되는데, 이때 단순히 noise만을 더해주는게 아니라 로 scaling하는 이유는 variance가 발산하는 것을 막기 위함이다.
- variance를 unit하게 가둠으로써 forward-reverse 과정에서 variance가 일정수준으로 유지될 수 있게 된다
- 이 값은 learnable parameter로 둘 수도 있지만, 실험을 해보니 상수로 두어도 큰 차이가 없어서 constant로 두었다고 한다.
- 데이터가 이미지와 비슷할 때에는 이 값을 매우 작게 설정하다가 gaussian distribution에 점점 가까워질 수록 이 값을 크게 설정 (10^-4에서 0.02로 linear하게 증가)
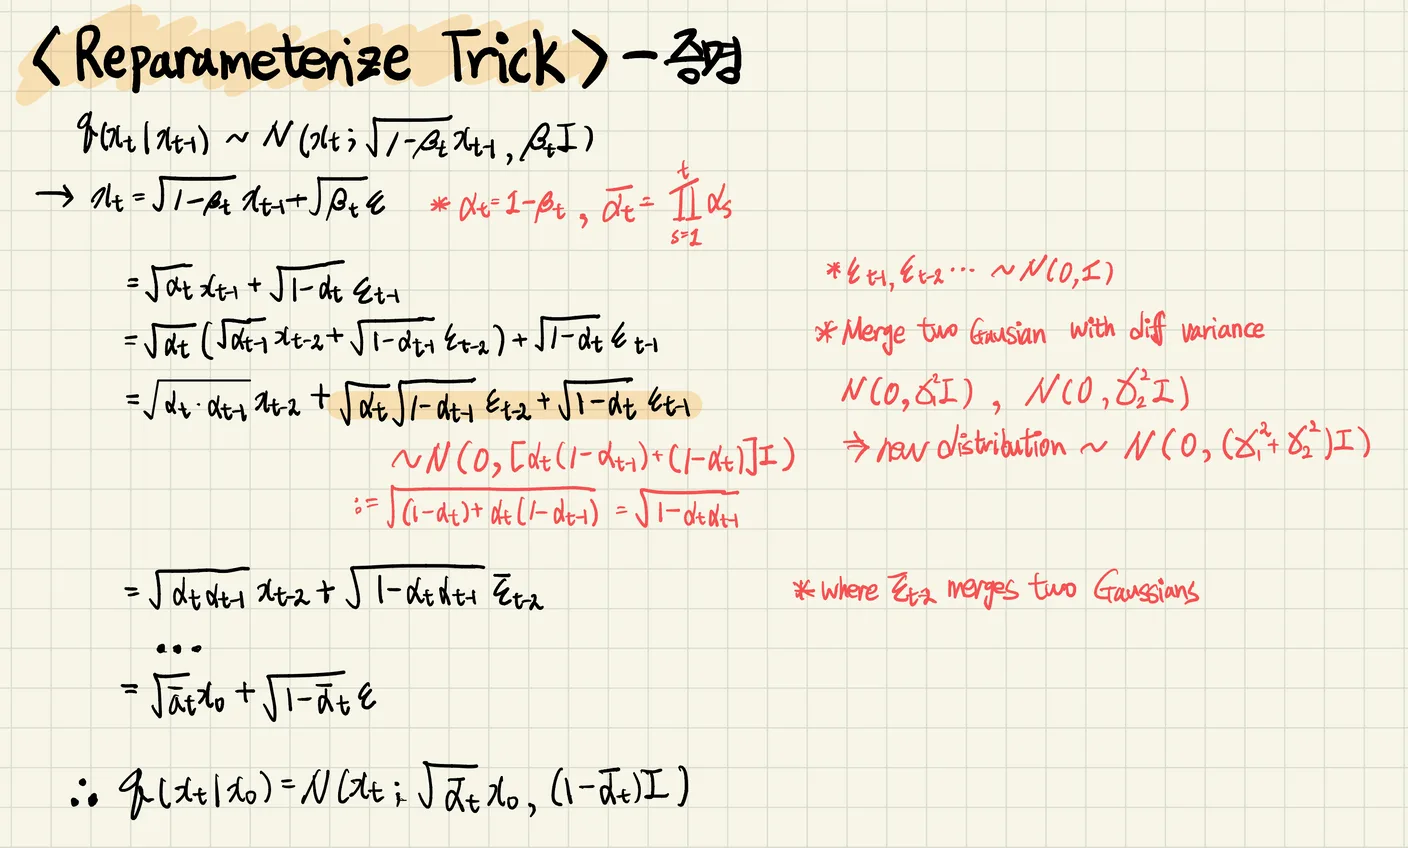
- t번의 sampling을 통해 매 step을 차근차근 밟아가면서 에서 를 만들 수도 있지만, 한번에 이를 할 수도 있다.
- 재귀적으로 식을 정리하다보면, 어떤 data 가 주어졌을 때 의 분포는 다음과 같다.
- 한 step씩 학습을 하면 메모리와 resource가 너무 많이 든다. 그러나 이런식으로 한번에 를 만들고 나면, 여기서 loss를 구한 다음에 t에 대한 expectation을 구하는 식으로 학습이 가능하다 (어차피 stochastic gradient를 사용하기 때문에 이런식으로 학습해도 무방)
(2) Reverse Diffusion Process (p)
- Reverse Diffusion Process p는 로부터 을 복원하는 과정이다.
- 최종적으로 random noise로부터 data를 generate하는 generative model로 사용되기 때문에 diffusion model을 사용하기 위해서는 모델링하는 것이 필수적이지만, 이를 실제로 알아내는 것은 쉽지 않다.
→ 우리가 알고 싶은건 이나, 이를 알긴 어려움.
- 그러므로 우리는 를 활용해서 이를 approximate한다. 이 때, 이 approximation은 Gaussian transition을 활용한 Markov chain의 형태를 가진다. 이를 식으로 표현하면 다음과 같다.
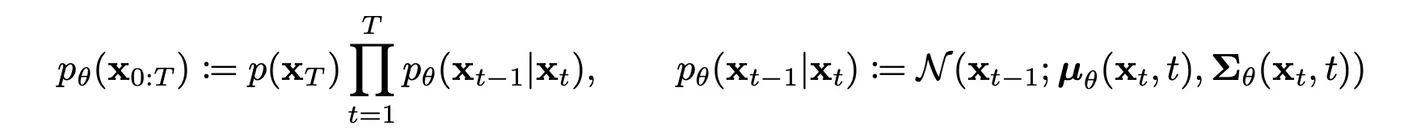
- 위 식에서, 각 단계의 정규 분포의 평균 와 표준편차 는 학습되어야 하는 parameter들이다. 그리고 위 식의 시작 지점인 noise의 분포는 다음과 같이 가장 간단한 형태의 표준정규분포로 정의한다.
(3) Objective Function (Loss)
- 이렇게 reverse process와 forward process가 무엇인지를 알았으니 이제 의 parameter 추정을 위해 diffusion model을 어떻게 학습을 하는지에 대해 알아보겠다.
- 우리는 앞서 언급했듯이 실제 data의 분포인 를 찾아내는 것을 목적으로 하기 때문에 결국 이의 likelihood를 최대화(음의 likelihood를 최소화)하는 것이 우리가 원하는 목적이다. 이를 식으로 나타내면 다음과 같다.
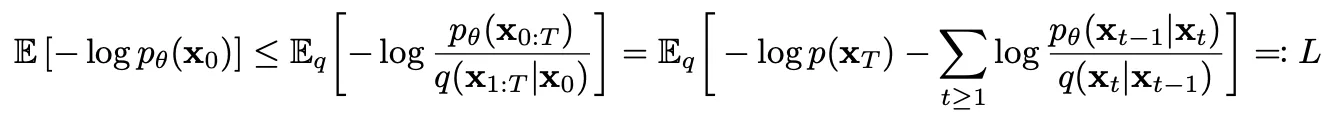
증명 보기
: 쿨백-라이블러 발산 (Kullback–Leibler divergence, KLD)
- 두 확률분포의 차이를 계산하는 데에 사용
- 또한 training loss의 세 번째 등호는 우리가 reverse process와 forward process를 Markov chain으로 정의했기 때문에 Markov property에 의해 성립한다.
Markov property
어떤 시간에 특정 state에 도달하든 그 이전에 어떤 state를 거쳐왔든 다음 state로 갈 확률은 항상 같다는 성질
- 마지막으로, 위 식을 좀 더 쉽게 계산하기 위해 다음과 같은 Gaussian 분포 간의 KL divergence 형태로 식을 변형한다.
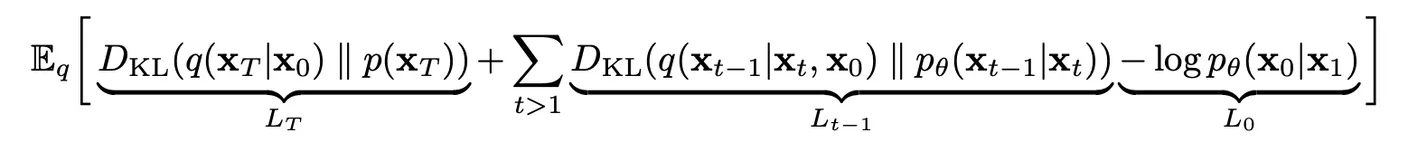
- 위 식에서 각각의 term이 가지는 의미를 하나씩 살펴보면 다음과 같다. 앞서 정리해 둔 수식들을 활용해보자.
- LT: p가 generate하는 와 가 라는 데이터가 주어졌을 때 generate하는 간의 분포 차이
- Lt−1: p와 q의 reverse / forward process의 분포 차이. 이들을 최대한 비슷한 방향으로 학습한다.
- L0: latent x1으로부터 data x0를 추정하는 likelihood. 이를 maximize하는 방향으로 학습한다.
와
(1)
(2)
와
(1) 는 알 수 없지만, 은 알 수 있다.
by Bayes’ rule → posterior, prior 사용!
(2)
증명 보기
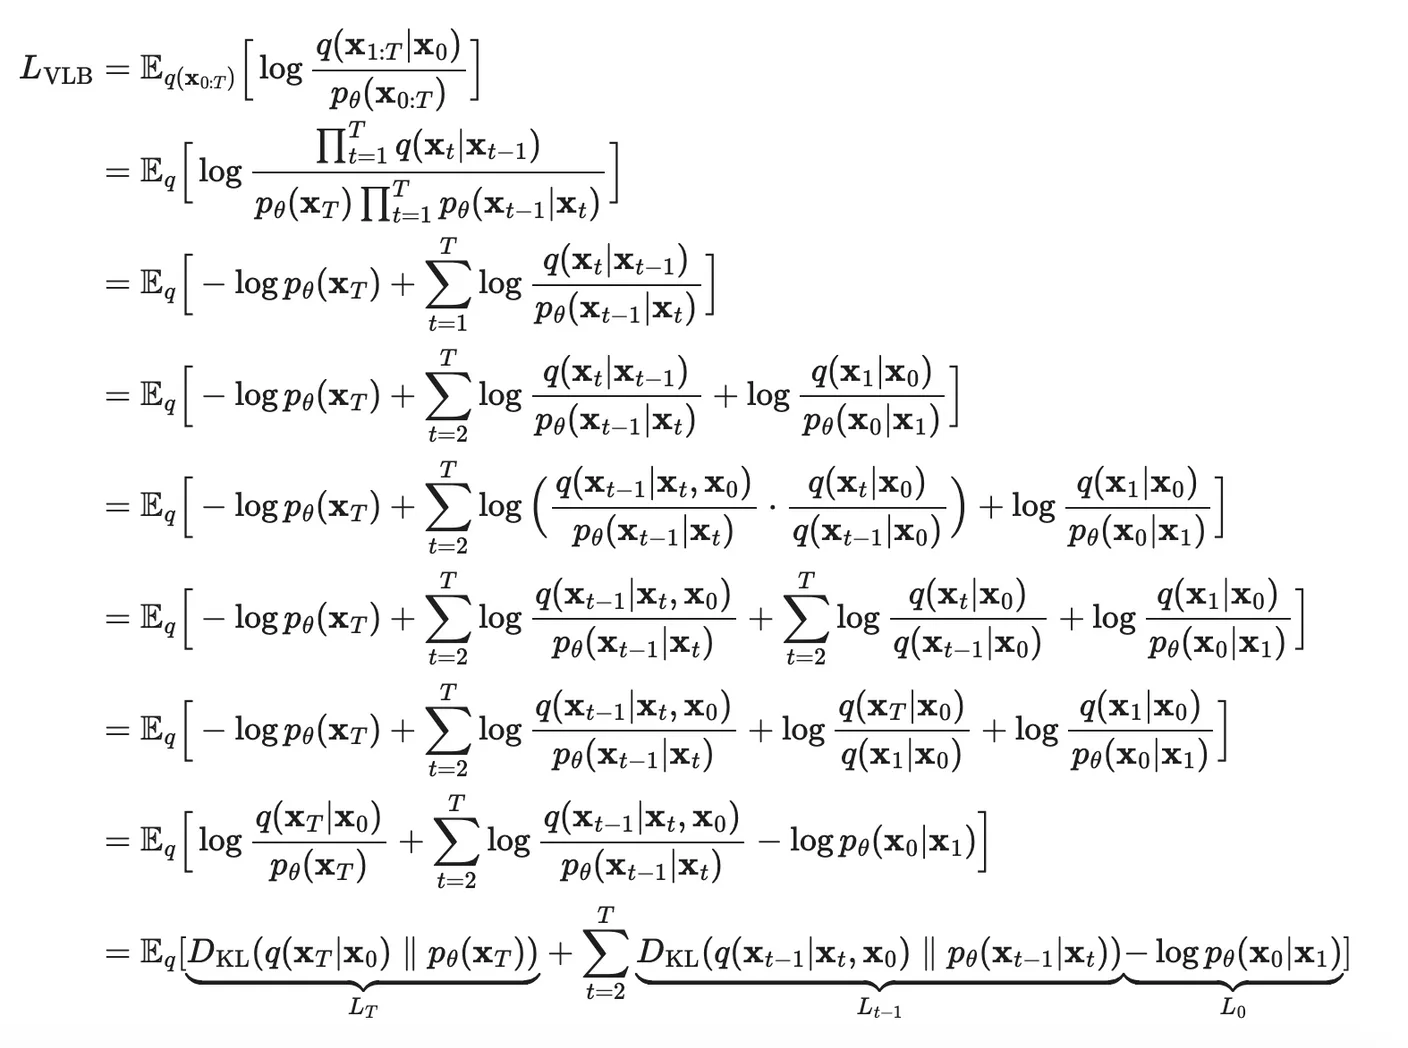
- 결론적으로, 우리가 diffusion model을 학습할 때의 training loss는 정규 분포 사이의 KL divergence 형태로 쉽게 계산될 수 있는 것이다.
References
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 33, 6840-6851.